02//AUSGEWÄHLTES WERK

Geschichten aus der Technik,
nicht nur Projektnamen.

Drei Systeme, die zeigen, wie ich von einer echten Einschränkung zu einem zuverlässigen, beobachtbaren Ergebnis übergehe.

THEMENSAMMLUNG

Cloud-Betrieb: Erfahrungen, die zusammenhängen

CDN, Monitoring, Virtualisierung und AWS. Vier Geschichten darüber, wie Systeme besser funktionieren.

Sammlung entdecken ↗
FALL 02

FULL-STACK · DATENVISUALISIERUNG · MOBILE UX

63getrackte Sitzungen

Ich habe Kraftwerk als App zur Eingabe von Trainingsdaten programmiert: Übungen, Gewichte und Wiederholungen pro Satz. Sie verbindet das Trainingsprotokoll mit Verlauf und Fortschrittsanalysen.

Herausforderung

Bringen Sie fragmentierte Sitzungs-, Volumen- und Aktivitätsdaten in einen vertrauenswürdigen Verlauf, ohne die Trainingsprotokollierung zu verlangsamen.

Vorgehensweise

Verwenden Sie validierte Datensätze, Import-Workflows, adaptive Pläne und auswählbare tägliche, wöchentliche und monatliche Diagrammbereiche.

Ergebnis

Eine Trainingsansicht für Mobilgeräte mit anhaltenden Trainingseinheiten, übersichtlichem Volumenfortschritt, Schrittdaten und langfristigen Trends.

Lesen Sie die Fallstudie

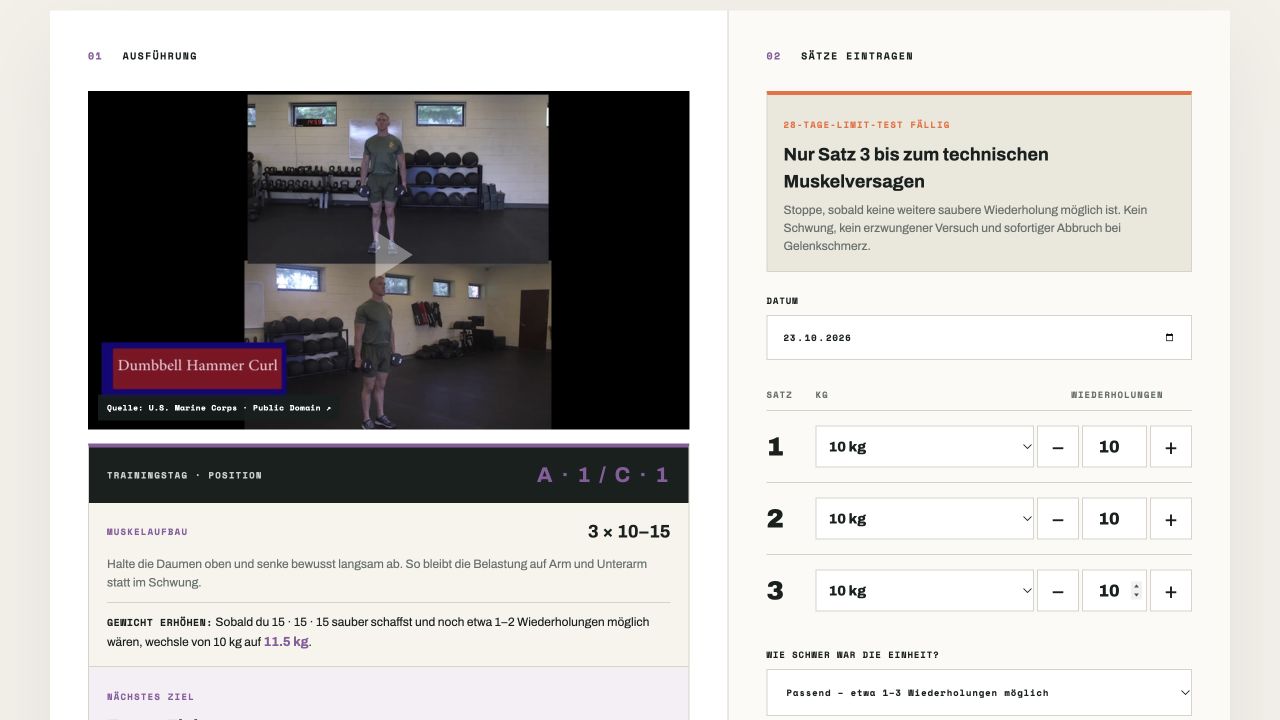
Die selbst programmierte App. In der App wähle ich eine Übung aus und erfasse Trainingsdatum, Gewichte und Wiederholungen für jeden Satz direkt. Die gespeicherten Einheiten bilden die Grundlage für Verlauf, Volumenberechnung und Fortschrittsdiagramme. Die öffentliche Kraftwerk-Seite zeigt eine reine Leseansicht dieses Trainingsverlaufs. Wie Kraftwerk entstanden ist →

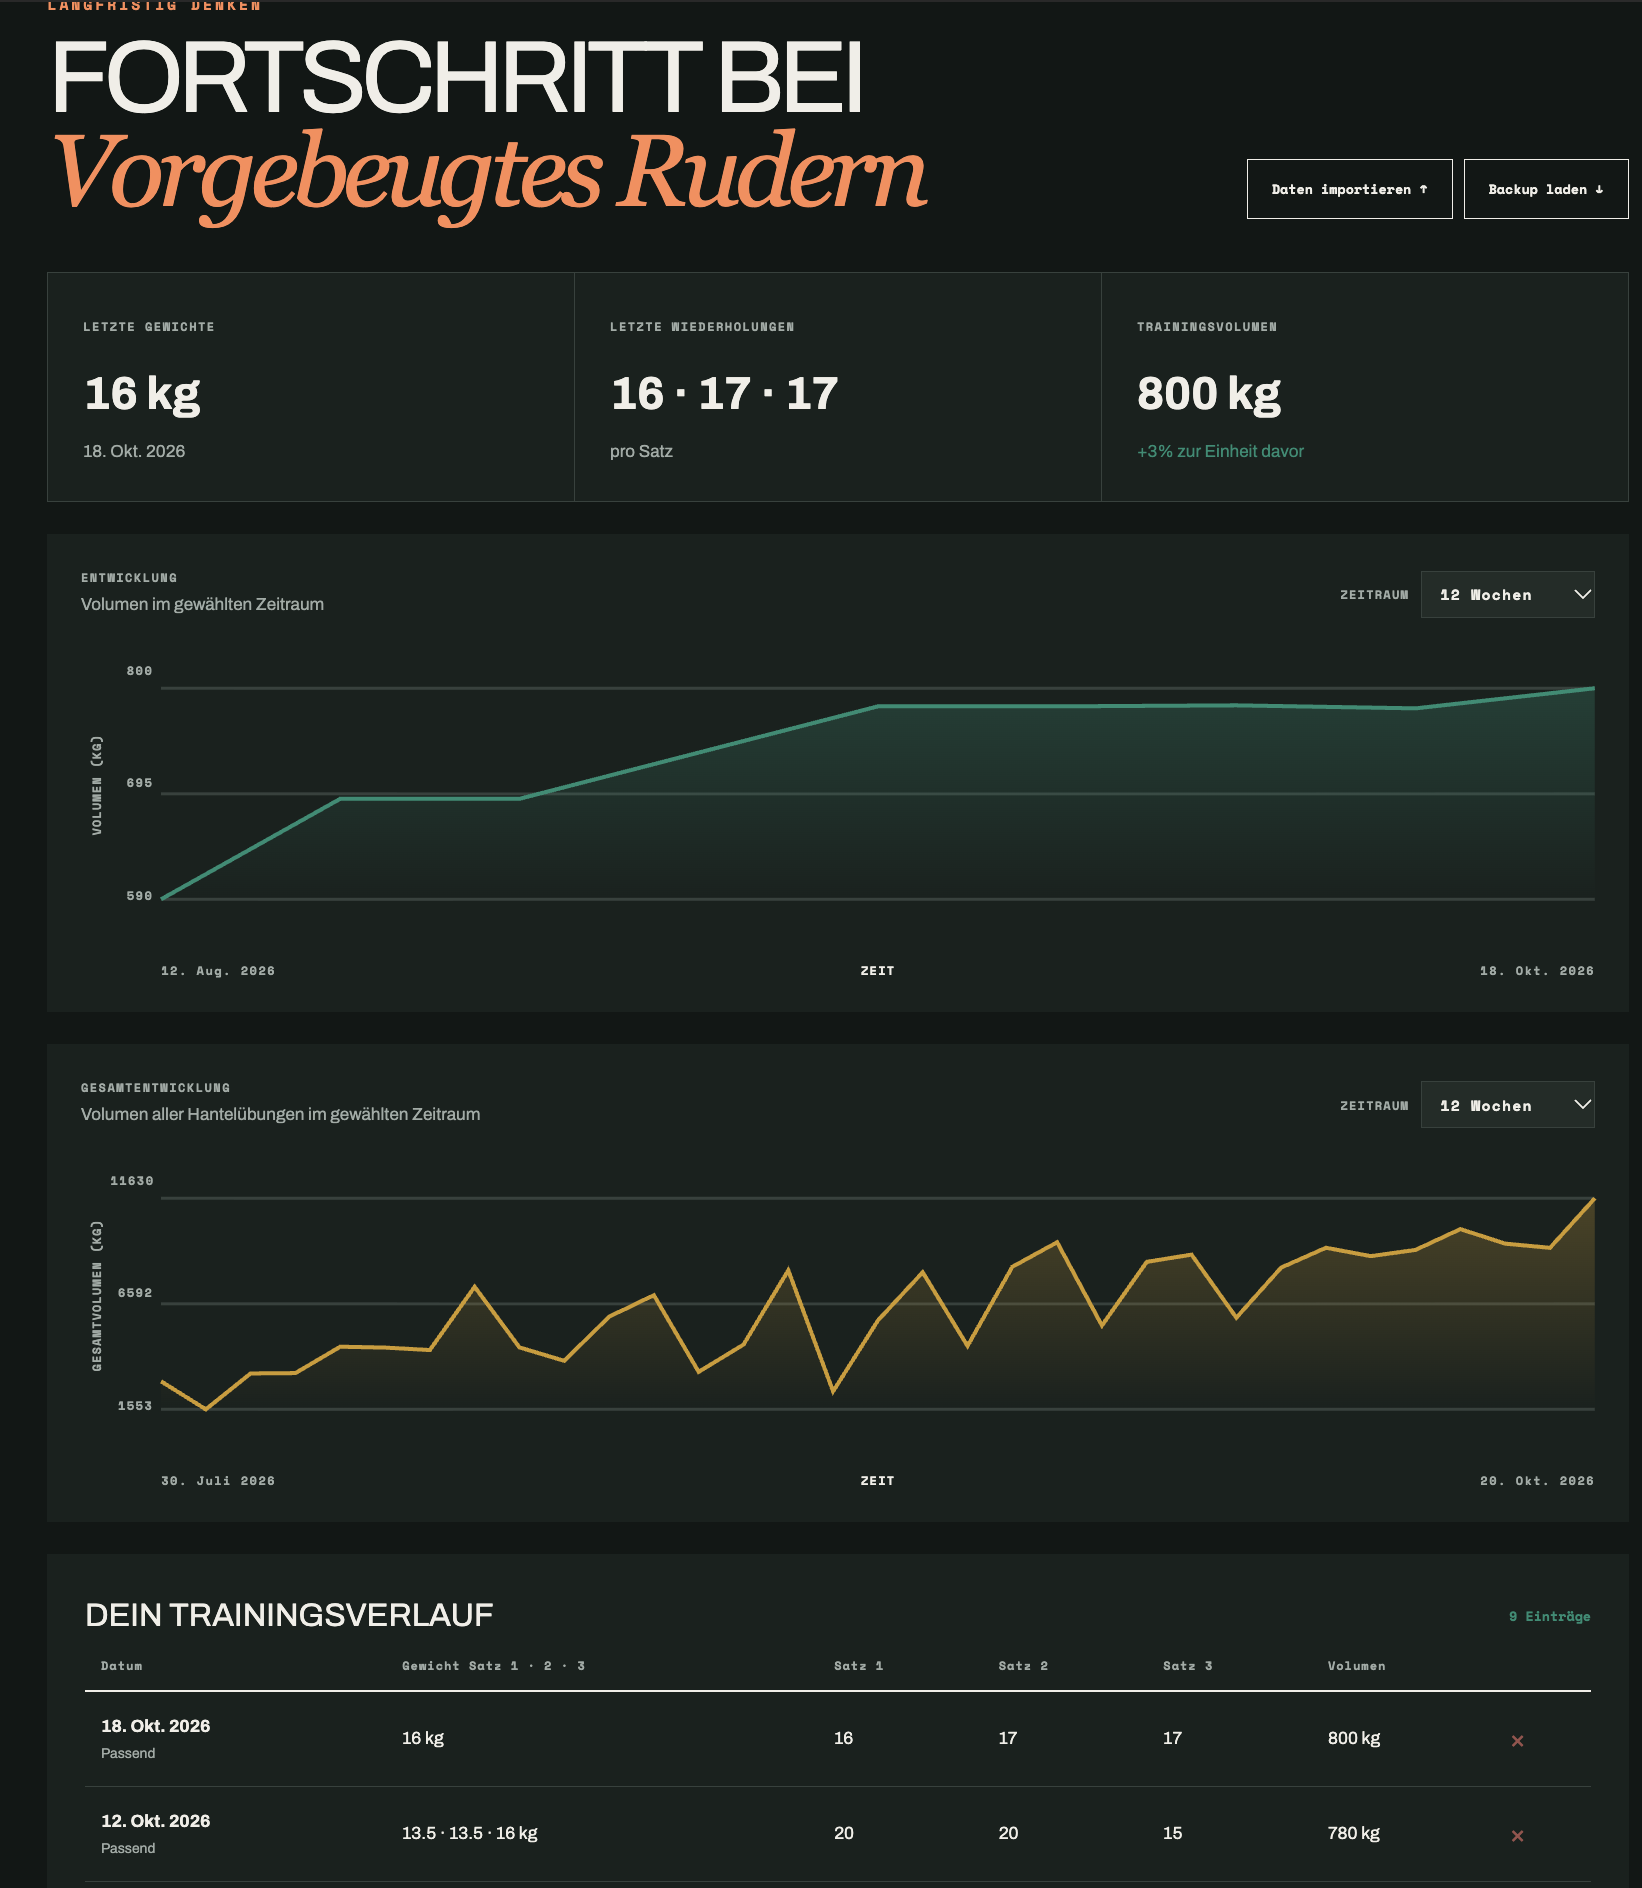
Daten mit Kontext. Sitzungskennzahlen, Gesamtvolumen, Schritte und Zeitbereichskontrollen sorgen dafür, dass einzelne Trainingseinheiten innerhalb von Wochen- und Monatsmustern aussagekräftig sind.

Gebaut, um sich weiterzuentwickeln. CSV- und Gesundheitsdatenimporte sorgen dafür, dass historische Informationen übertragbar sind, während die Präsentationsebene neue Kennzahlen abrufen kann, ohne die zugrunde liegenden Datensätze neu schreiben zu müssen.

KRAFTWERK / MISSION LOG

Von Papier zu Fortschritt.

Vier Stationen einer App, die aus meinem eigenen Training entstand.

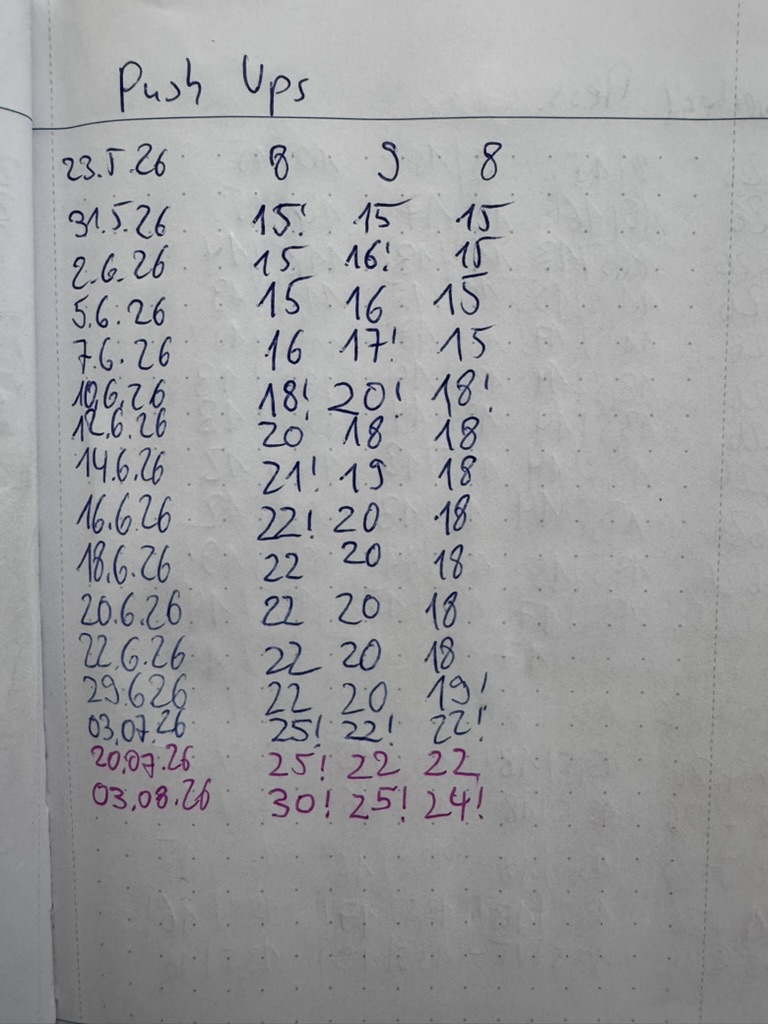
Meine ursprünglichen Push-up-Aufzeichnungen.
Station 1 / 4
Am Anfang stand die Kladde.

Die passende Trainings-App fand ich nicht. Also notierte ich Datum und Wiederholungen von Hand. Das ist meine ursprüngliche Push-up-Seite.

  • Responsive Benutzeroberfläche
  • Validierte APIs
  • CSV-Import
  • Gesundheitsdaten
  • Interaktive Charts
FALL 03

BEOBACHTBARKEIT · BETRIEB · AUTOMATISIERUNG

24/7Bereitschaftsteam

Als ich 2000 dazukam, gab es eine Handvoll Server und Skripte zur Logauswertung. Was für den Anfang genügt hatte, konnte mit dem Wachstum und der zunehmenden Komplexität nicht mithalten.

Herausforderung

Reaktive Logauswertung durch ein mitwachsendes Monitoring ersetzen und Probleme erkennen, bevor Nutzer sie melden.

Vorgehensweise

Mit Nagios und Zabbix starten, Service-Checks und Alarmierung aufbauen und Performancemetriken für Trendanalysen aufzeichnen.

Ergebnis

Eine über die Jahre gewachsene Monitoring-Praxis, später ergänzt durch Grafana und Checkmk: früh warnen und die langfristige Entwicklung verstehen.

Lesen Sie die Fallstudie

Kleine Umgebung, wachsende blinde Flecken. Am Anfang standen nur eine Handvoll Server und Skripte, die Logfiles analysierten. Mit dem Wachstum stieß dieser Ansatz an Grenzen: Er skalierte nicht ausreichend und konnte die zunehmende Komplexität nicht mehr abbilden. Vor allem war er reaktiv – er zeigte, was bereits passiert war.

Chef und Kunden sind keine Monitoring-Werkzeuge. Warum ein Problem erst bemerken, wenn es schon eingetreten ist? Wenn der Chef oder gar ein Kunde als Erster eine Störung meldet, läuft der Betrieb der Situation bereits hinterher. Neben dem eigentlichen Ausfall steht dann auch das Vertrauen in die Arbeit des Teams auf dem Spiel – nach innen wie nach außen.

Der Klassiker: auslaufende TLS-Zertifikate. 2000 gab es die heute vertrauten Möglichkeiten zur automatischen Zertifikatserneuerung noch nicht in dieser Form. Let’s Encrypt kam erst deutlich später, 2015. Wir mussten bevorstehende Ablaufdaten überwachen, statt sie durch eine fehlgeschlagene Verbindung zu entdecken. Anforderungen und Zertifikatsanbieter können unterschiedlich sein; auch eine automatisierte Erneuerung muss überwacht werden.

Erkennen, melden und Daten behalten. Unsere erste Wahl waren Nagios und Zabbix. Wir brauchten Prüfungen, die Probleme erkannten, und Meldungen, die jemanden erreichten, der handeln konnte. Die Benachrichtigungen gingen insbesondere an das 24/7-Bereitschaftsteam, damit Störungen rund um die Uhr bearbeitet werden konnten. Aus Kostengründen hatte die Website damals noch keine High-Availability-Architektur. Zuverlässige Erkennung und schnelle Reaktion waren deshalb entscheidend, um eine möglichst hohe Servicequalität zu sichern; das Monitoring selbst beseitigte das Ausfallrisiko nicht. Über die Jahre kamen unterschiedliche Meldewege zum Einsatz, darunter SMS, WhatsApp und PagerDuty. Das beschreibt die spätere Entwicklung, nicht einen vollständigen Werkzeugkasten von 2000.

Vom einzelnen Alarm zur Entwicklung über Zeit. Aufgezeichnete Performancemetriken ermöglichten den Blick über den einzelnen Alarm hinaus: Wie entwickelten sich Last, Latenzen und verfügbare Kapazität? Später ergänzten Grafana und Checkmk die Werkzeuglandschaft. Das Ziel blieb, Verschlechterungen früher zu erkennen und anhand der Daten zu verstehen, wohin sich die Systeme entwickelten.

Der Gedanke dahinter. Monitoring ist mehr als eine Sammlung von Dashboards. Es soll dem Team die Chance geben, zu handeln, bevor jemand anders auf ein Problem aufmerksam machen muss.

Historische Quelle: Ankündigung des ersten öffentlichen Let’s-Encrypt-Zertifikats (2015).

  • Nagios
  • Zabbix
  • Grafana
  • Checkmk
ZUSÄTZLICHE WIRKUNG
01 / PERFORMANCE · 2008

Statische Inhalte von den Webservern entkoppeln

Mit Akamai rund 90% unserer Objekte nah an den Nutzern cachen und eine bis dahin vollständig auf Bare Metal betriebene Webserver-Farm entlasten.

~90% Objekte nutzernah gecacht
Projektgeschichte lesen

Die Ausgangslage

2008 bestand die Plattform aus Bare-Metal-Webservern hinter einem einzelnen Loadbalancer. Eine Cache-Schicht gab es nicht: Auch Anfragen nach statischen Inhalten gingen direkt an die Webserver-Farm. Als Wetterdienstleister hatten wir eine extrem schwankende Nachfrage. Abhängig vom Wetter und anderen Großereignissen verzeichneten wir an einzelnen Tagen rund 20-mal so viel Traffic wie gewöhnlich – vergleichbar mit dem Ansturm auf Amazon am Black Friday. Wir brauchten deshalb ein System, das mit diesen Lastspitzen skalieren konnte.

Der Engpass

Bei hohen Anfrageraten wurde die verfügbare Socket-Kapazität zum Engpass. Die Website war dann zeitweise kaum noch erreichbar – obwohl ein großer Teil der Inhalte nicht bei jedem Abruf erneut vom Origin ausgeliefert werden musste.

Die Veränderung

Durch die Einführung von Akamai konnten wir rund 90% unserer Objekte nah an den Nutzern cachen. Am Origin kamen nur noch etwa 10% der Requests an – rund 90% der Anfragen wurden also ausgelagert. Diese Entlastung ermöglichte es uns sogar, die Webserver-Farm zu verkleinern.

Mehr Handlungsspielraum

An besonders laststarken Tagen hatten wir nun einen zusätzlichen Hebel: Für geeignete Inhalte ließen sich die Cache-Zeiten erhöhen und die Origin-Last weiter reduzieren. Entscheidend war, wo eine längere Vorhaltezeit inhaltlich vertretbar war – nicht ein pauschaler Wert für alles.

Die Erkenntnis: Wiederholt abgerufene Inhalte gehören näher zu den Nutzern. Eine passende Cache-Strategie schafft neben Geschwindigkeit auch betrieblichen Handlungsspielraum. Historischer Projektüberblick; Infrastrukturkennungen und interne Betriebsdetails bleiben bewusst außen vor.

02 / MODERNISIERUNG

Von Bare Metal zu VMware

Ein Storage-Projekt, das seine ursprünglichen Latenzanforderungen nicht erfüllte, wurde zur erfolgreichen Virtualisierungsplattform – und zum Wendepunkt in meinem Blick auf Infrastruktur.

> 10.000 € monatlich an Rackkosten gespart
Projektgeschichte lesen

Ein Projekt, auf das ich besonders stolz bin

Als Systemadministrator kann ich Konfigurationen und Architekturen verändern. Hardwaregrenzen lassen sich dagegen nicht einfach mit einem Software-Patch beseitigen. Wir hatten ein Storage-System gekauft, um einen Cache-Layer zwischen die Webserver und die Produktionssysteme zu setzen.

Der Proof of Concept war nicht das ganze Bild

Das System bestand unseren Proof of Concept. Unter echter Last im operationellen Betrieb waren die Latenzen für den vorgesehenen Einsatzzweck dann aber zu hoch. Damit stand ein Projekt mit einer Investition von mehreren Hunderttausend Euro auf dem Spiel. Mussten wir den Misserfolg eingestehen und die Investition abschreiben?

Dieselbe Investition, ein anderer Ansatz

Wir änderten die Richtung. Statt das Storage aufzugeben, nutzten wir es als Grundlage, um unsere Bare-Metal-Server mit VMware zu virtualisieren. Der ursprüngliche Cache-Layer ließ sich so nicht realisieren – aber in einer anderen Architektur hatte die Hardware weiterhin einen Wert.

Aus dem Rückschlag wurde ein messbarer Erfolg

Am Ende stand ein erfolgreiches Virtualisierungsprojekt. Durch die Konsolidierung der physischen Server sparten wir außerdem monatlich mehr als 10.000 Euro Rackkosten. Aus einer gefährdeten Investition war eine Plattform mit klarem betrieblichem und wirtschaftlichem Nutzen geworden.

Warum mich das zu AWS führte

Obwohl das Ergebnis ein voller Erfolg war, blieb ein Wunsch: Infrastruktur dynamisch erzeugen und verändern zu können – so wie Software. Dieser Gedanke hat mich nicht mehr losgelassen. Kein Wunder also, dass ich irgendwann mein Herz an AWS verlor.

03 / KREATIVES PROGRAMMIEREN

Browser Arcade

Wie viele Deutsche Mark habe ich als Kind wohl für diese Spiele ausgegeben? Keine Ahnung. Heute kann ich mit Codex meine eigenen Browserversionen bauen.

2 spielbare Browsergames
Die Geschichte lesen

Ein kleines Experiment

Ich wollte einfach einmal sehen, ob Codex mit ein paar Screenshots und einigen Informationen das Spielgefühl im Browser nachbauen kann. Aus dieser Neugier entstand Browser Arcade: meine eigenen Versionen von Snake und Galaga.

Vom Taschengeld zum Selbermachen

Ich weiß nicht, wie viele Deutsche Mark ich als Kind in diese Spiele gesteckt habe. Damals habe ich bezahlt, um spielen zu dürfen. Heute kann ich selbst eine Version zum Leben erwecken – und muss darüber immer noch grinsen.

Die Freude am Ausprobieren

Entstanden sind zwei spielbare Browsergames, einfach aus Spaß am Experimentieren. Aus einer Kindheitserinnerung wurde etwas, das ich selbst bauen, verändern und teilen kann.

Snake ↗ · Galaga ↗

Wischen Sie oder verwenden Sie die Pfeiltasten · Esc wird geschlossen