02/ OBRA SELECCIONADA

Historias de ingeniería,
no solo nombres de proyectos.

Tres sistemas que muestran cómo paso de una restricción real a un resultado fiable y observable.

COLECCIÓN DESTACADA

Operaciones cloud: experiencias que conectan

CDN, monitorización, virtualización y AWS. Cuatro historias sobre cómo mejorar los sistemas.

Explorar la colección ↗
CASO 02

PILA COMPLETA · VISUALIZACIÓN DE DATOS · EXPERIENCIA DE USUARIO MÓVIL

63sesiones rastreadas

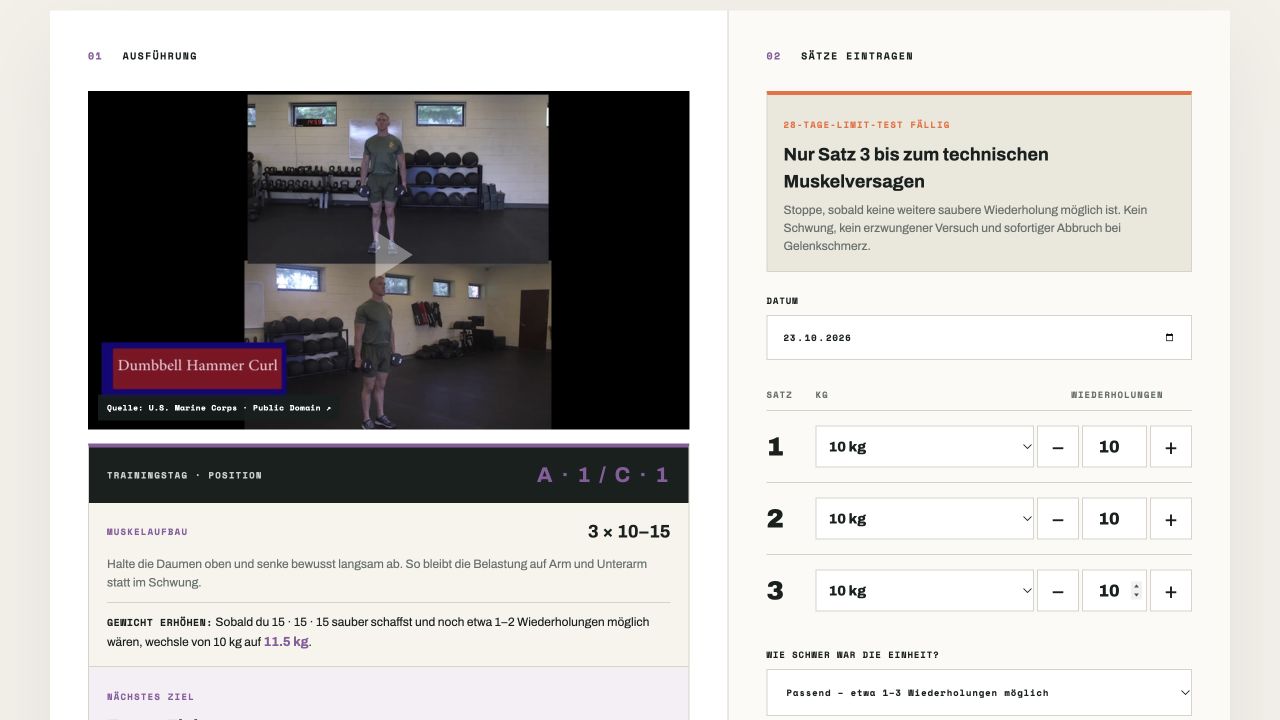
Programé Kraftwerk como una aplicación para introducir datos de entrenamiento: ejercicios, pesos y repeticiones por serie. Combina el registro de sesiones con el historial y el análisis del progreso.

Desafío

Reúna los datos fragmentados de las sesiones, el volumen y la actividad en un historial fiable sin ralentizar el registro de los entrenamientos.

Enfoque

Utilice registros validados, flujos de trabajo de importación, planes adaptables y rangos de gráficos diarios, semanales y mensuales seleccionables.

Resultado

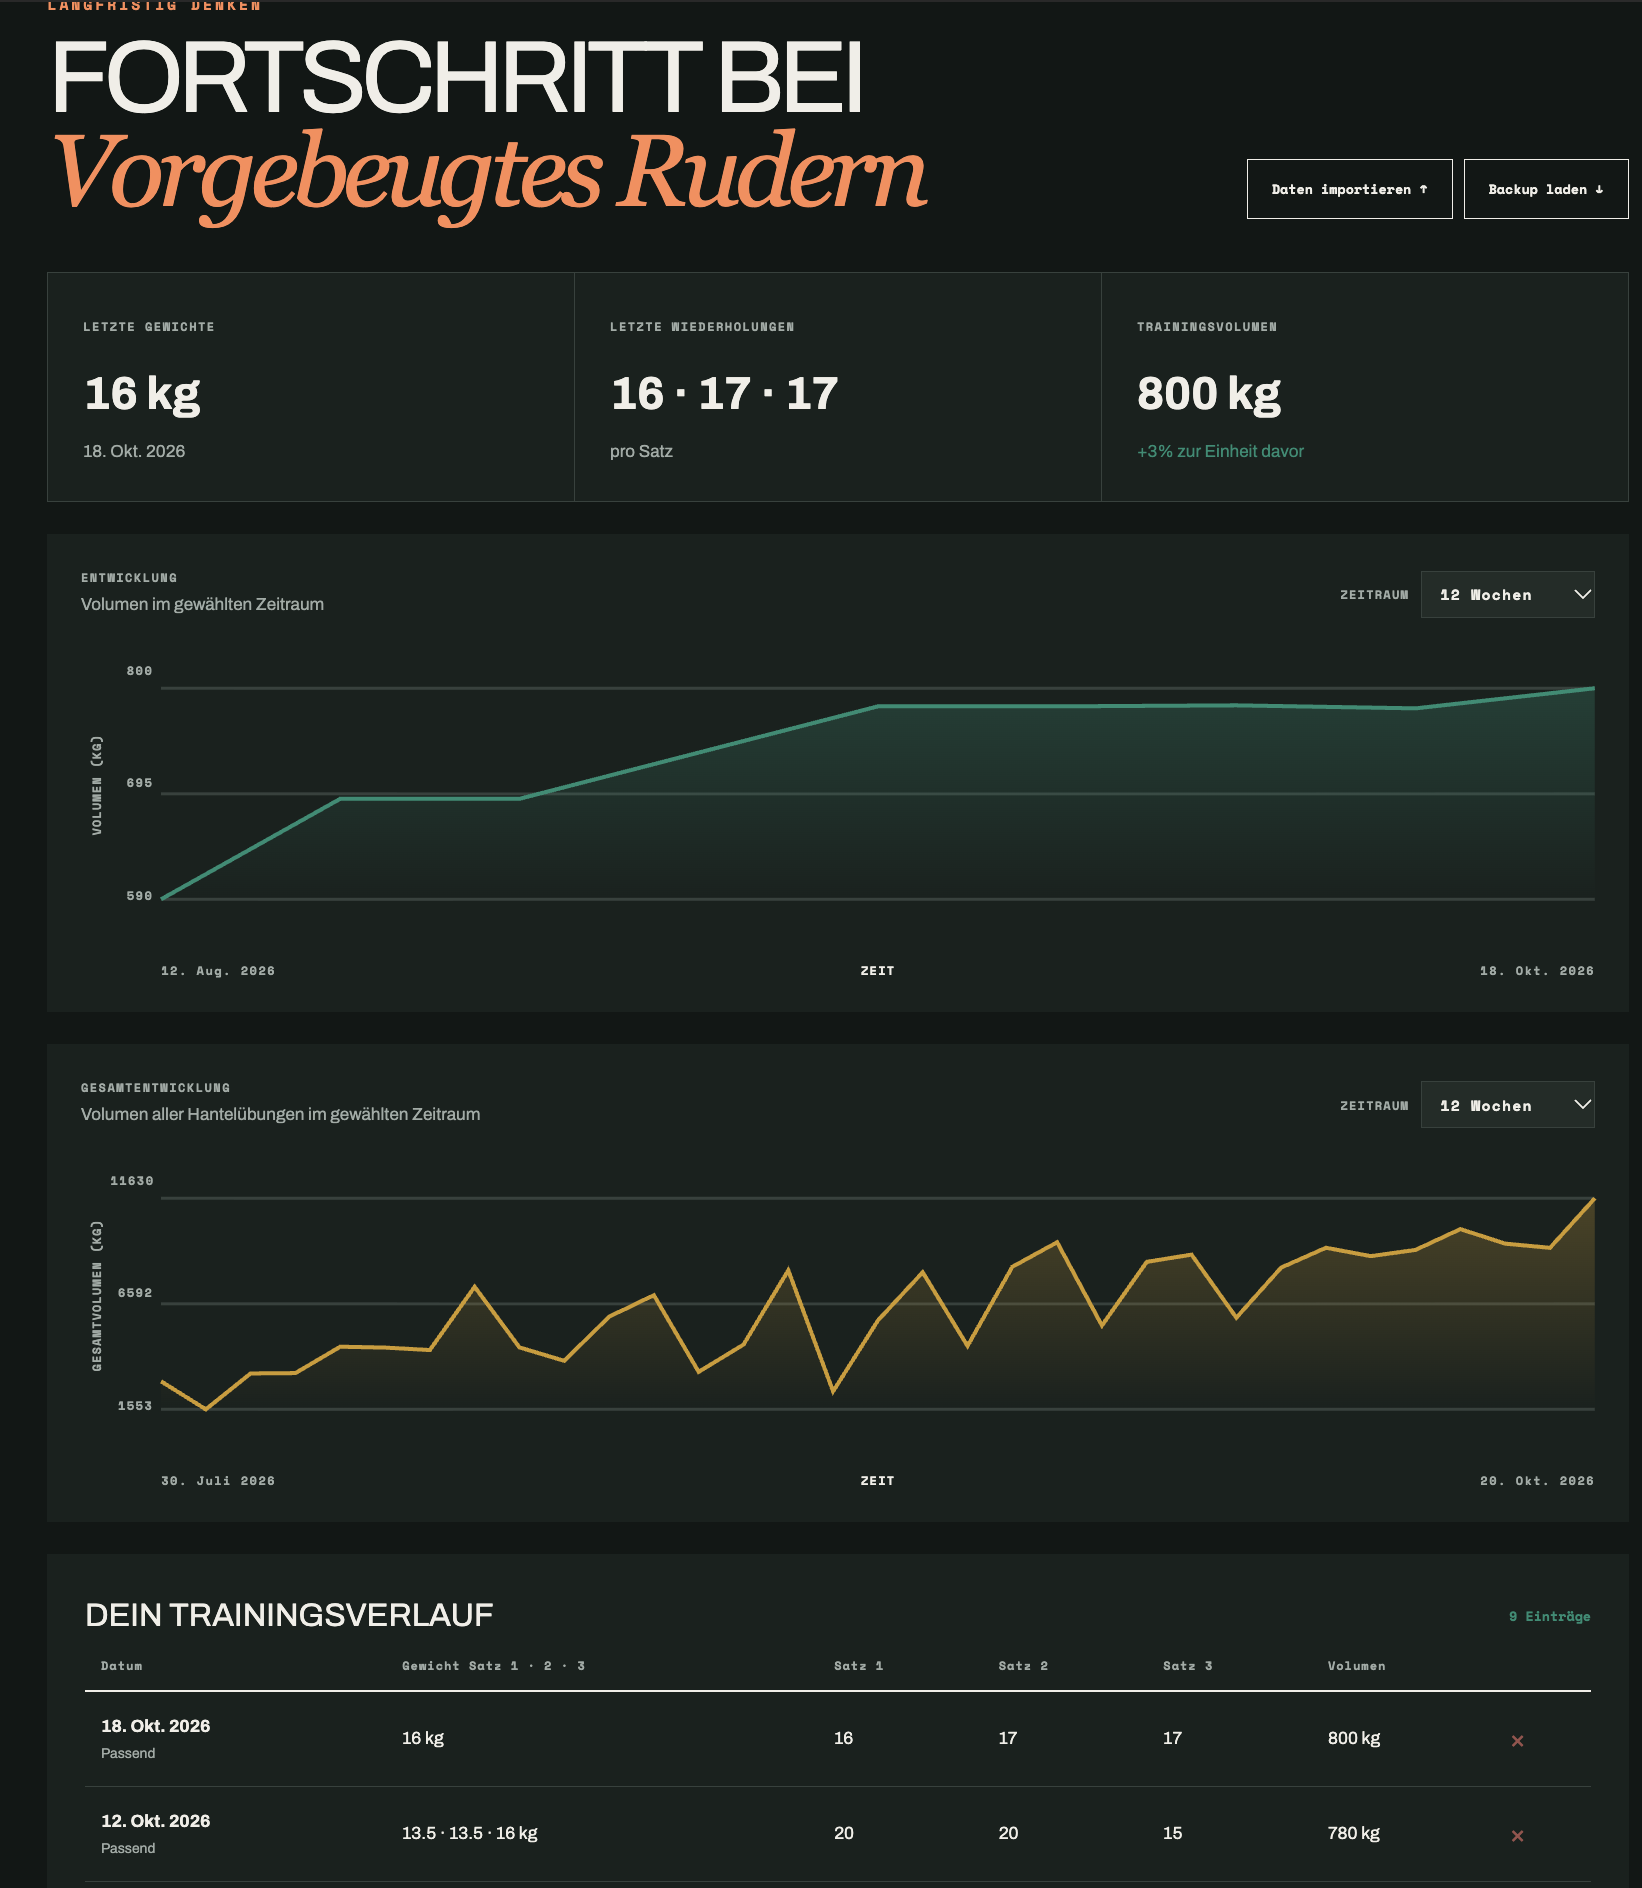
Una visión del entrenamiento que prioriza los dispositivos móviles, con sesiones persistentes, progreso de volumen claro, datos de pasos y tendencias a largo plazo.

Lea el estudio de caso

La aplicación que programé. La aplicación permite elegir un ejercicio e introducir la fecha, los pesos y las repeticiones de cada serie. Las sesiones guardadas alimentan el historial, el cálculo del volumen y los gráficos de progreso. La página pública de Kraftwerk muestra una vista de solo lectura de ese historial. Cómo nació Kraftwerk →

Datos con contexto. Las métricas de la sesión, el volumen total, los pasos y los controles de rango temporal hacen que los entrenamientos individuales sean significativos dentro de los patrones semanales y mensuales.

Creado para evolucionar. La importación de CSV y datos de salud mantiene la información histórica portátil, mientras que la capa de presentación puede obtener nuevas métricas sin reescribir los registros subyacentes.

KRAFTWERK / MISSION LOG

Del papel al progreso.

Cuatro etapas de una app nacida de mi propio entrenamiento.

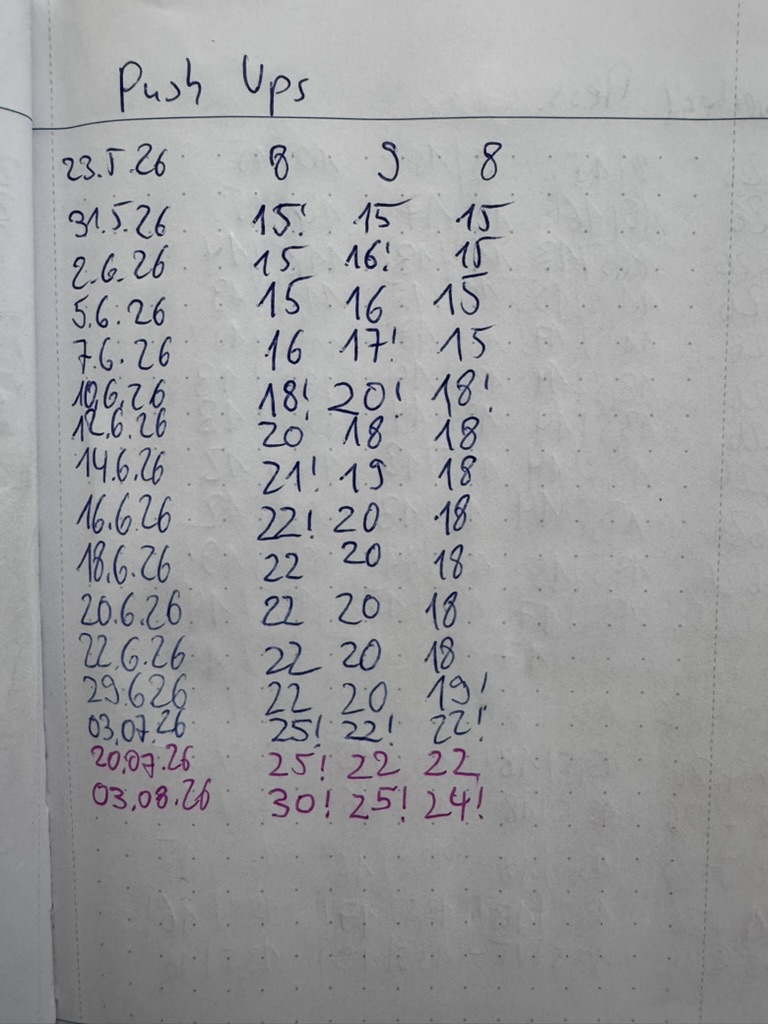
Mis notas originales de flexiones.
Etapa 1 / 4
Todo empezó en un cuaderno.

No encontraba la app adecuada. Así que anoté fechas y repeticiones a mano. Esta es mi página original de flexiones.

  • Interfaz de usuario responsiva
  • API validadas
  • Importación de CSV
  • Datos de salud
  • Gráficos interactivos
CASO 03

OBSERVABILIDAD · OPERACIONES · AUTOMATIZACIÓN

24/7equipo de guardia

Cuando me incorporé en 2000, había unos pocos servidores y scripts que analizaban logs. Ese enfoque no podía seguir el ritmo del crecimiento ni de la complejidad.

Reto

Sustituir el análisis reactivo de logs por una monitorización escalable que detectara problemas antes de que los usuarios los comunicaran.

Enfoque

Empezar con Nagios y Zabbix, añadir comprobaciones y avisos y registrar métricas para analizar tendencias.

Resultado

Una práctica que evolucionó con el tiempo, incorporando después Grafana y Checkmk para combinar alertas tempranas y visibilidad a largo plazo.

Lea el estudio de caso

Un entorno pequeño con puntos ciegos crecientes. Al principio solo había unos pocos servidores y scripts de análisis de logs. Con el crecimiento, el enfoque dejó de escalar y de representar la complejidad. Además, era reactivo: mostraba lo que ya había ocurrido.

El jefe y el cliente no son herramientas de monitorización. ¿Por qué descubrir un problema cuando ya ha sucedido? Si un responsable o un cliente es el primero en comunicar una caída, operaciones ya llega tarde. Además del incidente, queda en riesgo la confianza en el trabajo del equipo, dentro y fuera de la organización.

El clásico: un certificado TLS a punto de caducar. En 2000 no existían de la misma forma las opciones actuales de renovación automática. Let’s Encrypt llegó mucho después, en 2015. Necesitábamos vigilar la caducidad antes de descubrirla mediante una conexión fallida. Los requisitos y emisores pueden variar; incluso la renovación automatizada necesita supervisión.

Detectar, avisar y conservar datos. Nuestras primeras opciones fueron Nagios y Zabbix. Hacían falta comprobaciones y avisos que llegaran a alguien capaz de actuar. Los avisos se dirigían especialmente al equipo de guardia 24/7 para atender incidentes a cualquier hora. Por motivos de coste, la web todavía no tenía una arquitectura de alta disponibilidad. La detección fiable y la respuesta rápida eran esenciales para mantener la mejor calidad de servicio posible; la monitorización no eliminaba por sí sola el riesgo de interrupciones. Con los años, los canales incluyeron SMS, WhatsApp y PagerDuty; no significa que todos se utilizaran ya en 2000.

Del incidente a la tendencia. Registrar métricas permitía estudiar cómo evolucionaban carga, latencia y capacidad, más allá de una alarma aislada. Después se añadieron Grafana y Checkmk. El objetivo seguía siendo detectar antes el deterioro y entender hacia dónde se dirigían los sistemas.

El principio que permanece. La monitorización es más que una colección de paneles: debe dar al equipo la oportunidad de actuar antes de que otra persona tenga que señalar el problema.

Fuente histórica: anuncio del primer certificado público de Let’s Encrypt (2015).

  • Nagios
  • Zabbix
  • Grafana
  • Checkmk
IMPACTO ADICIONAL
01 / RENDIMIENTO · 2008

Separar la entrega estática de los servidores web

Introdujimos Akamai para almacenar cerca de los usuarios alrededor del 90% de nuestros objetos y aliviar una granja de servidores físicos.

~90% objetos en caché cerca del usuario
Leer la historia del proyecto

El punto de partida

En 2008, la plataforma utilizaba servidores físicos detrás de un único balanceador. No había una capa de caché: incluso las peticiones de contenido estático llegaban directamente a la granja web. Como proveedor de servicios meteorológicos, afrontábamos una demanda extremadamente variable. Según el tiempo y otros grandes acontecimientos, algunos días registrábamos unas 20 veces el tráfico habitual, comparable al salto de demanda de un comercio en Black Friday. Necesitábamos un sistema capaz de escalar con esos picos.

El cuello de botella

Con tasas elevadas de peticiones, la capacidad disponible de sockets se convertía en un límite. La web podía dejar de responder aunque gran parte del contenido no necesitara servirse repetidamente desde el origen.

El cambio

Con Akamai pudimos almacenar cerca de los usuarios alrededor del 90% de nuestros objetos. Solo alrededor del 10% de las peticiones seguía llegando al origen: una descarga de aproximadamente el 90%. Esa reducción permitió incluso disminuir la granja de servidores.

Más margen operativo

En días de carga intensa, ampliar la duración de caché de contenidos adecuados ofrecía otra forma de reducir peticiones al origen. Había que decidir dónde era aceptable conservar una copia más tiempo, en lugar de aplicar el mismo valor a todo.

La lección: acercar el contenido reutilizable al usuario y tratar la política de caché como una herramienta operativa. Resumen de un proyecto histórico; se omiten identificadores y detalles internos de operación.

02 / MODERNIZACIÓN

Del bare metal a VMware

Un proyecto de almacenamiento que no cumplió sus requisitos originales de latencia se convirtió en una plataforma de virtualización y cambió mi manera de entender la infraestructura.

> 10.000 € ahorro mensual en costes de racks
Leer la historia del proyecto

Un proyecto del que estoy especialmente orgulloso

Como administrador de sistemas podía cambiar configuraciones y arquitectura, pero no eliminar cualquier límite del hardware con un parche. Compramos un sistema de almacenamiento para crear una capa de caché entre los servidores web y los sistemas de producción.

La prueba de concepto no lo mostraba todo

El sistema superó la prueba de concepto. Sin embargo, con carga operativa real, la latencia era demasiado alta para el uso previsto. Estaba en riesgo una inversión de varios cientos de miles de euros. ¿Teníamos que admitir el fracaso y darla por perdida?

Otra aplicación para la misma inversión

Cambiamos de enfoque. En lugar de abandonar el almacenamiento, lo utilizamos como base para virtualizar nuestros servidores físicos con VMware. El plan original de caché no funcionó, pero el hardware seguía teniendo valor en otra arquitectura.

Un contratiempo convertido en éxito medible

El resultado fue un proyecto de virtualización exitoso. La consolidación de servidores también permitió ahorrar más de 10.000 euros mensuales en costes de racks. Una inversión en riesgo se convirtió en una plataforma con un beneficio operativo y económico claro.

El camino hacia AWS

Aunque el desenlace fue un éxito, me dejó un deseo: poder crear y cambiar infraestructura dinámicamente, como software. Esa idea permaneció conmigo y ayuda a explicar por qué finalmente me enamoré de AWS.

03 / PROGRAMACIÓN CREATIVA

Browser Arcade

¿Cuántos marcos alemanes gasté de niño en estos juegos? No lo sé. Hoy puedo crear mis propias versiones para el navegador con Codex.

2 juegos de navegador
Leer la historia

Un pequeño experimento

Quería comprobar si Codex podía recrear la sensación de un juego en el navegador a partir de unas capturas y algo de información. De esa curiosidad nació Browser Arcade: mis propias versiones de Snake y Galaga.

De la paga a crear por mi cuenta

No sé cuántos marcos alemanes me dejé en estos juegos de niño. Entonces pagaba por jugar. Hoy puedo ayudar a dar vida a una versión propia, y eso todavía me hace sonreír.

El placer de probar

El resultado son dos juegos de navegador creados por el gusto de experimentar. Un recuerdo de infancia se convirtió en algo que puedo construir, cambiar y compartir.

Snake ↗ · Galaga ↗

Desliza o usa las teclas de flecha · Esc se cierra