02 / 项目实践

看看项目背后的故事,
不只是技术名称。

三个项目,记录我如何面对实际限制,把想法落成可靠、可观测的系统。

精选主题

云运维:串起项目背后的经验

CDN、监控、虚拟化与 AWS。四个关于如何让系统运行得更好的故事。

浏览主题合集 ↗
案例 02

全栈开发 · 数据可视化 · 移动端体验

63已记录的训练次数

我编写了 Kraftwerk 训练应用,用于录入动作、每组重量和重复次数。它将训练记录、历史和进度分析结合在一起。

挑战

将分散的训练、训练量和活动数据整理成可信的历史记录,同时让日常录入保持简便。

方法

校验导入记录,保留清晰的导入流程与可调整的计划,并支持按日、周、月查看图表。

成果

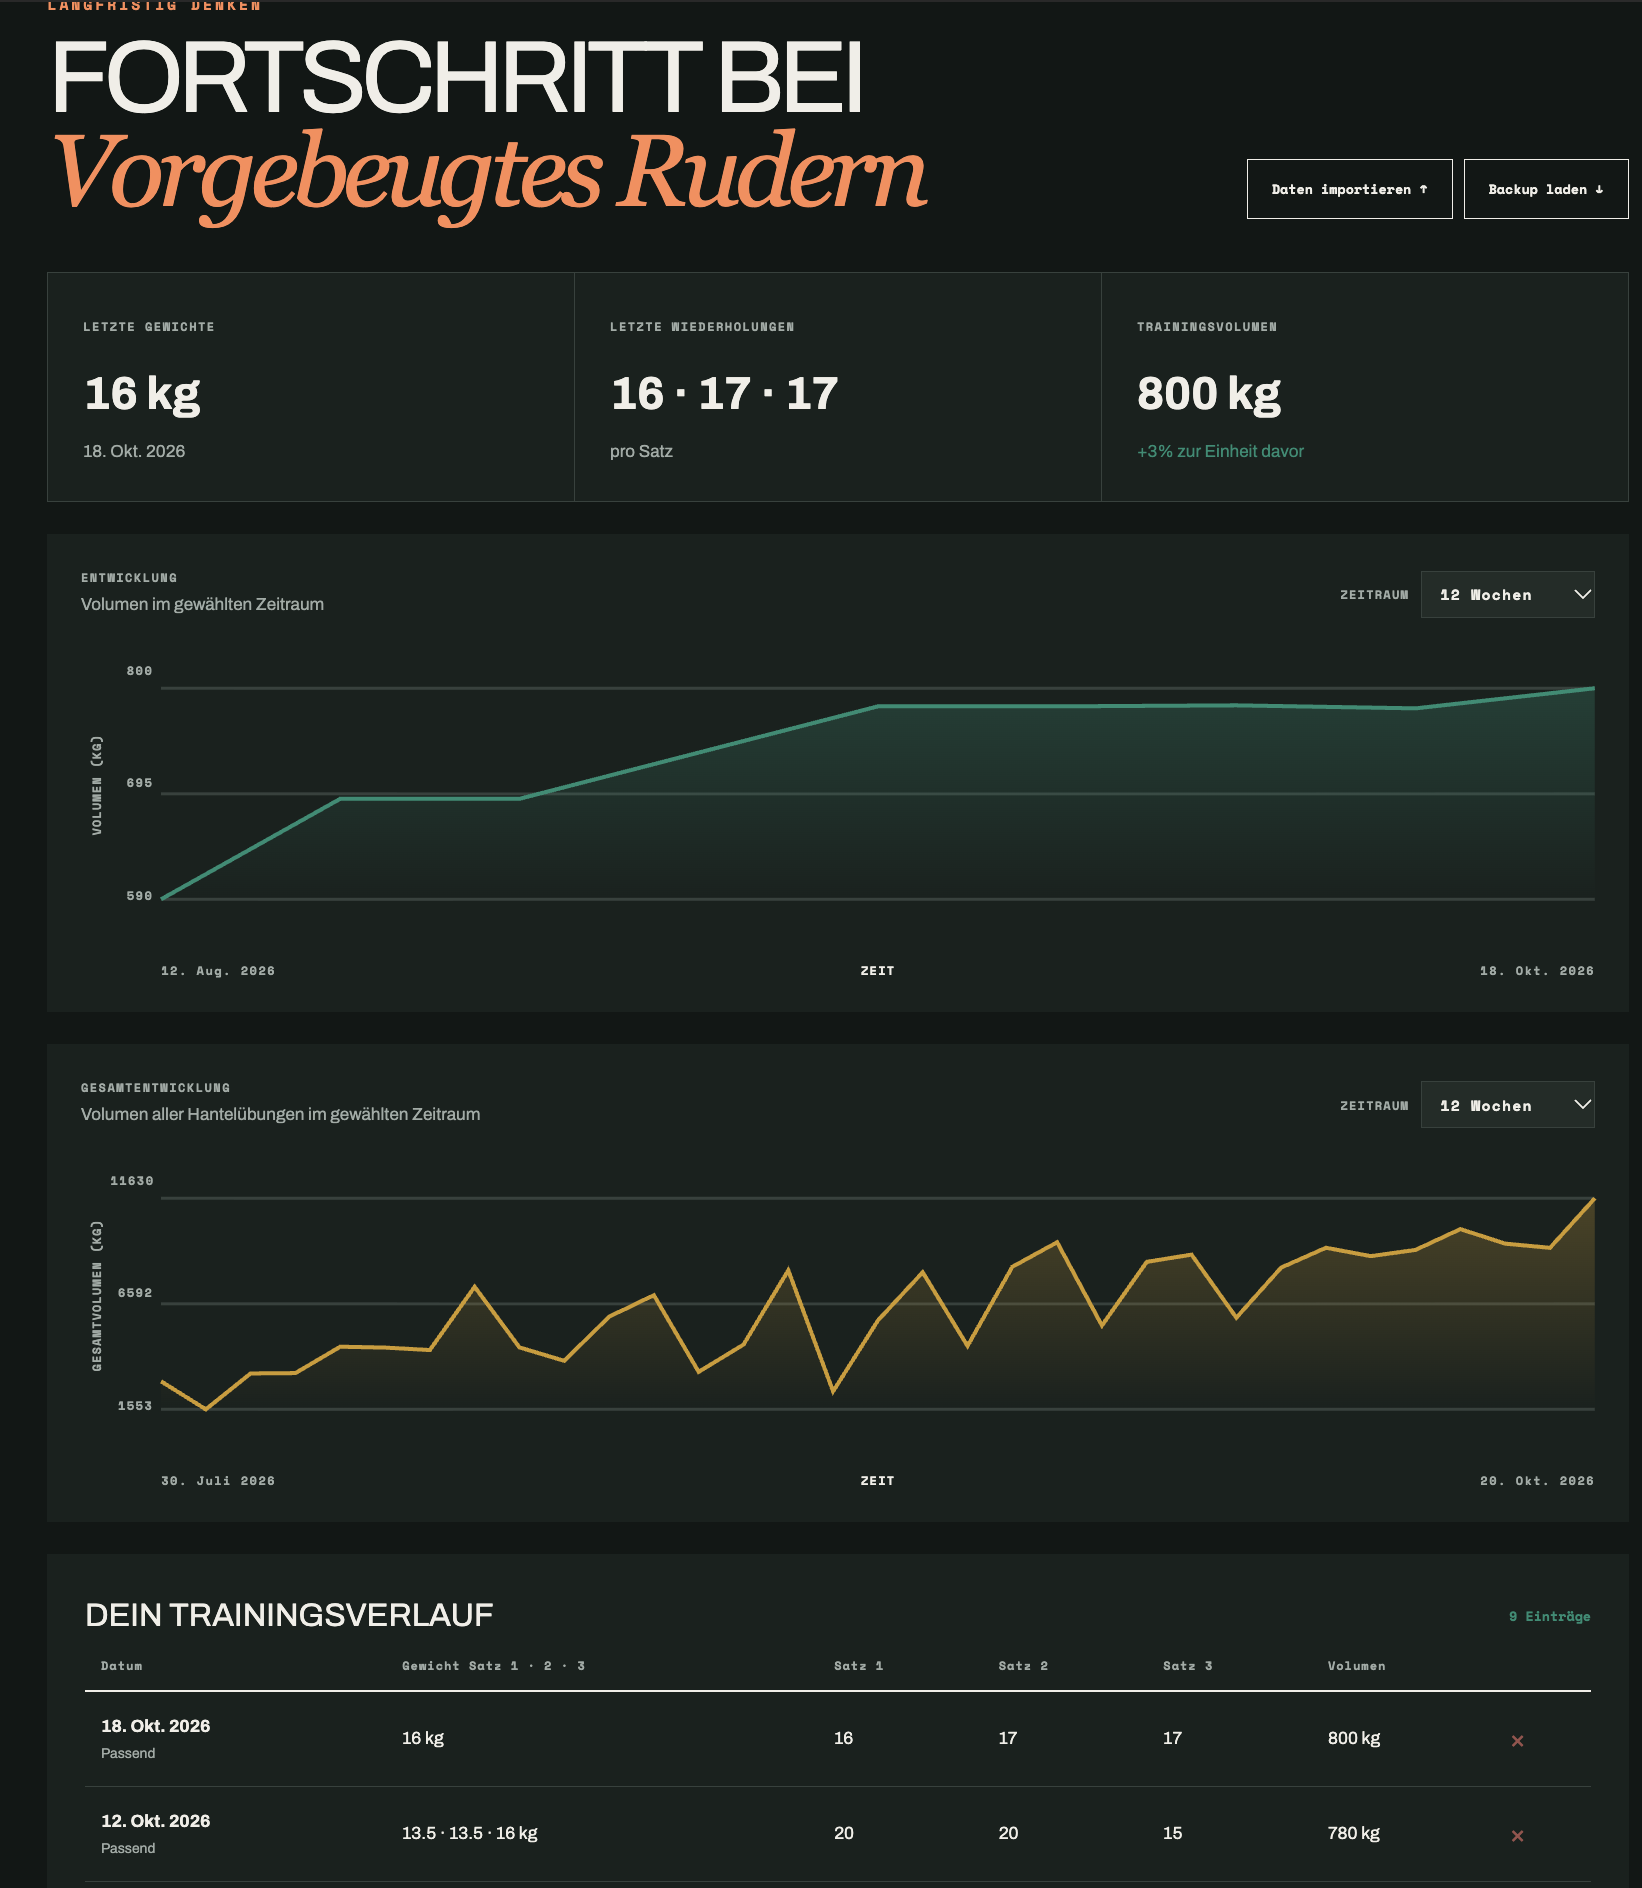
以手机使用为优先,持续保存训练记录,展示训练量变化、步数和长期趋势。

阅读项目故事

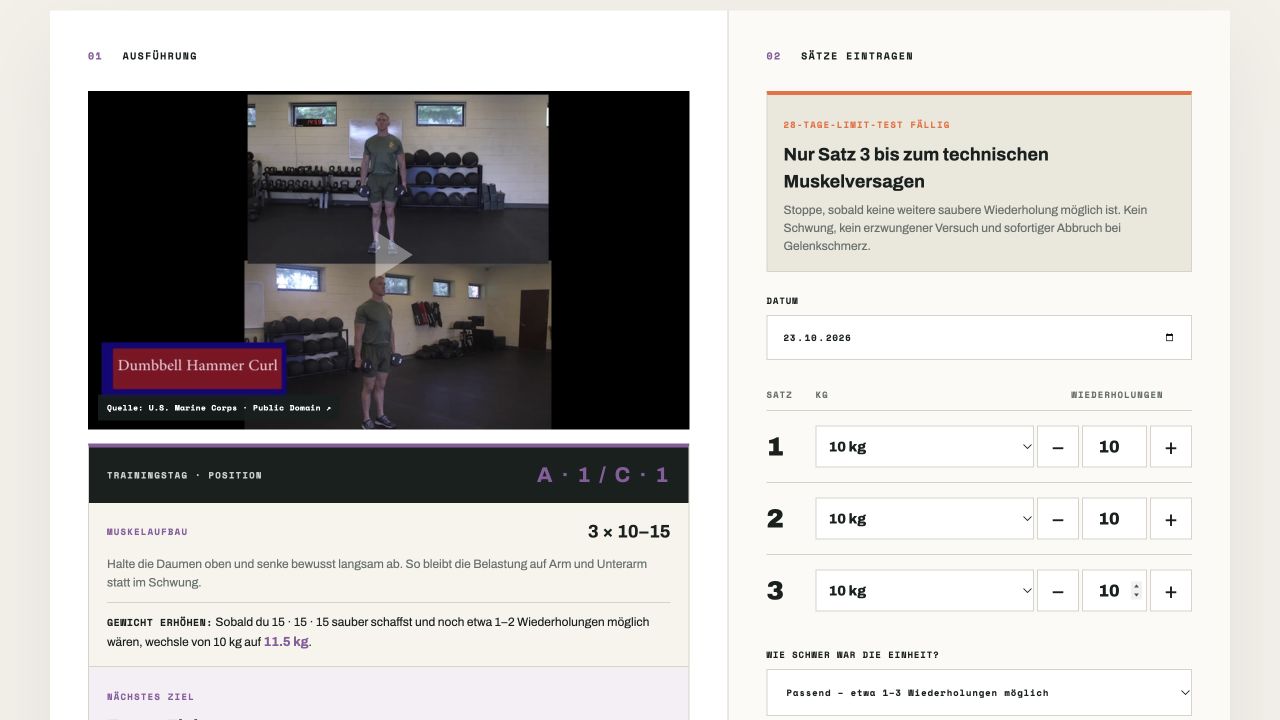
我编写的训练应用。 在应用中选择动作,直接录入训练日期以及每组的重量和重复次数。保存的训练数据用于历史记录、训练量计算和进度图表。公开的 Kraftwerk 页面提供这些训练历史的只读展示。 了解 Kraftwerk 的开发故事 →

数据需要上下文。 训练指标、总训练量、步数和时间范围选择,让单次训练可以放进每周、每月的变化中理解。

为后续改进留出空间。 CSV 与健康数据导入让历史记录可以迁移。展示层则能增加新指标,而不必重写底层记录。

KRAFTWERK / MISSION LOG

从纸笔记录到看见进步。

一款源于个人训练需求的应用,走过四个阶段。

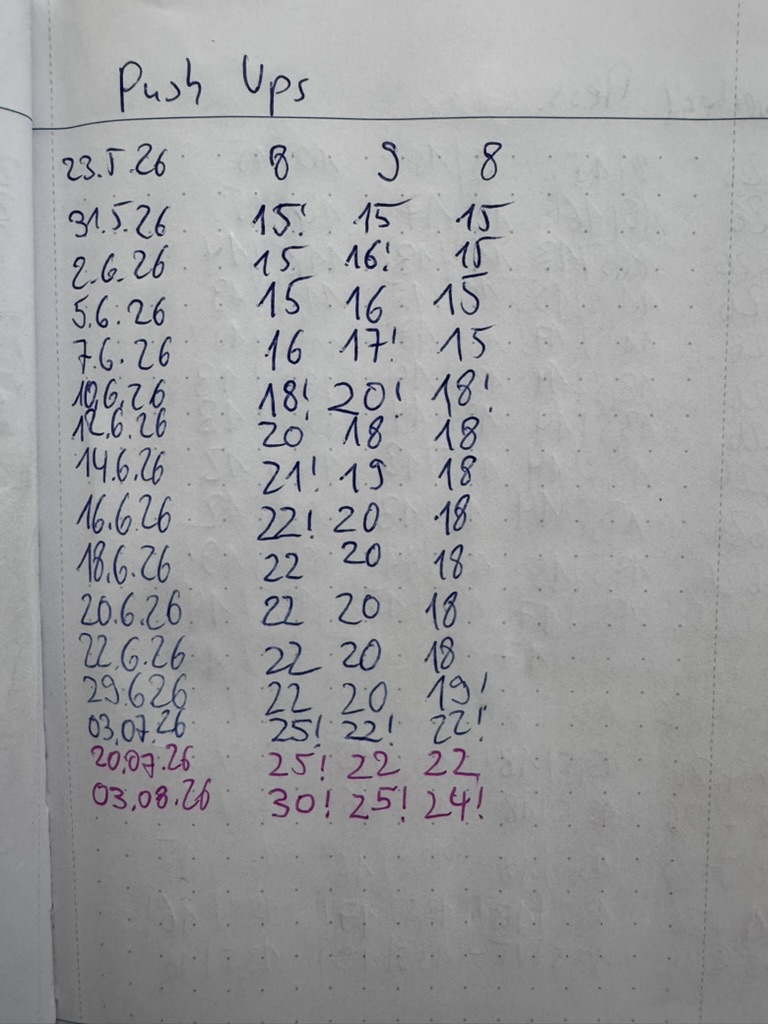
我的原始俯卧撑笔记。
我的原始俯卧撑笔记。
阶段 1 / 4
一切从笔记本开始。

找不到合适的训练应用,我便手写日期和次数。这是我的原始俯卧撑记录。

  • 响应式用户界面
  • 经过校验的 API
  • CSV 导入
  • 健康数据
  • 交互式图表
案例 03

可观测性 · 运维 · 自动化

24/7值班响应团队

2000 年我加入时,只有少量服务器和分析日志的脚本。这个起点无法跟上后来的规模增长和复杂度。

挑战

用可随环境增长的监控替代被动日志分析,在用户报告之前发现问题。

方法

首先选择 Nagios 和 Zabbix,建立服务检查与告警,记录性能指标以分析趋势。

结果

随着实践深入,工具中又加入了 Grafana 和 Checkmk,既用于提前预警,也帮助长期观察系统运行情况。

阅读项目故事

小环境,越来越多的盲点。 最初只有少量服务器和分析日志的脚本。随着平台增长,这种方式既难以扩展,也难以应对复杂度。更重要的是,它是被动的:反映的是已经发生的事情。

老板和客户不是监控工具。 为什么要等故障发生后才发现?如果最先报告问题的是管理者或客户,运维响应就已经晚了一步。故障之外,团队在公司内部和客户心中的信任也会受影响。

典型例子:即将到期的 TLS 证书。 2000 年还没有今天这样的自动续期工具,Let’s Encrypt 到 2015 年才出现。我们需要提前监控证书到期时间,而不是等连接失败才发现。即使后来使用了自动续期,证书要求和签发机构可能各不相同,监控仍然不可少。

发现、通知并保留数据。 最初我们选择了 Nagios 和 Zabbix。检查要能发现问题,告警也必须送达有能力处理问题的人,尤其是全天候待命的 24/7 值班响应团队。当时出于成本考虑,网站还没有高可用架构,及时发现和快速响应就格外重要。当然,监控本身不能消除停机风险。后来,通知渠道逐渐包括短信、WhatsApp 和 PagerDuty,并不是说这些工具在 2000 年就已全部使用。

从单次告警到趋势。 记录性能指标,可以研究负载、延迟和可用容量如何随时间变化,而不仅是看一个告警。后来,Grafana 和 Checkmk 也加入工具集。目标始终是更早发现恶化,并用数据理解系统的发展方向。

不变的原则。 监控不仅是一组仪表盘。它应该让团队有机会在别人必须指出问题之前采取行动。

历史来源:Let’s Encrypt 首个公开证书公告(2015 年)。

  • Nagios
  • Zabbix
  • Grafana
  • Checkmk
更多项目经历
01 / 性能 · 2008

让静态内容不再依赖每一次源站请求

引入 Akamai,将约 90% 的对象缓存在靠近用户的位置,减轻裸金属 Web 服务器集群的压力。

~90% 对象缓存在用户附近
阅读项目经历

最初的架构

2008 年,平台使用裸金属 Web 服务器,前端只有一个负载均衡器。没有缓存层,静态内容请求也直接到达 Web 服务器集群。作为气象服务提供商,我们面临极大的请求波动。受天气和其他重大事件影响,个别日期的流量约为平时的 20 倍,类似零售商在黑色星期五面临的需求激增。因此,我们需要能够随这些峰值扩展的系统。

遇到的瓶颈

请求速率很高时,可用的套接字容量成为瓶颈,网站有时难以响应。而其中许多内容并不需要每次都由源站重复提供。

引入 CDN 后

使用 Akamai 后,我们能够将约 90% 的对象缓存在用户附近。只有约 10% 的请求仍然到达源站,相当于卸载了约 90% 的请求。这种减负甚至让我们可以缩小 Web 服务器集群。

更多调节余地

在高负载日期,可以为合适的内容延长缓存有效期,进一步减轻源站负载。关键是判断哪些内容允许更长的缓存时间,而不是对所有内容采用同一个值。

这段经历让我认识到:把可复用的内容放到离用户更近的地方,也把缓存策略当作调节负载的工具。这里仅概述历史项目,不公开基础设施标识或内部运维细节。

02 / 现代化

从裸金属到 VMware

未能满足原定延迟要求的存储项目,最终成为成功的虚拟化平台,也改变了我对基础设施的看法。

> €10,000 每月节省的机架费用
阅读项目经历

一个让我特别自豪的项目

系统管理员可以调整配置与架构,却无法靠软件补丁消除所有硬件限制。我们曾购买一套存储系统,原计划在 Web 服务器与生产系统之间增加缓存层。

概念验证不是全貌

系统通过了概念验证,但在真实运行负载下,延迟对原定用途而言仍然过高。数十万欧元的投资面临风险。难道只能承认项目失败,把这笔投资作为损失处理吗?

同一笔投资,换一个方向

我们选择改变方向。没有放弃存储,而是将其作为基础,用 VMware 虚拟化原有的裸金属服务器。最初的缓存层方案未能实现,但硬件在另一种架构中仍有价值。

把挫折变成可衡量的成功

最终,虚拟化项目顺利完成。物理服务器整合之后,每月还节省了超过 10,000 欧元的机架费用。原本可能损失的一笔投入,变成了兼具运维价值和经济收益的平台。

为什么这让我走向 AWS

项目最终成功了,却也让我更想做到一件事:像编写软件一样,动态创建和调整基础设施。这个念头一直伴随着我,也让我后来爱上了 AWS。

03 / 创意编程

Browser Arcade

小时候在这些游戏上花了多少德国马克?我也不知道。如今,我可以用 Codex 构建自己的浏览器版本。

2 可玩的浏览器游戏
阅读故事

一个小实验

我只是想试试:给 Codex 几张截图和一些信息,能不能在浏览器里重现游戏的感觉?这份好奇心变成了 Browser Arcade:我自己的 Snake 和 Galaga 版本。

从零花钱到亲手创造

小时候到底在这些游戏上花了多少德国马克,我已经记不清了。那时得投币才能玩,如今却能自己动手做出一个版本。想到这里,还是觉得很开心。

尝试本身的乐趣

最终得到两个可以玩的浏览器游戏,纯粹出于实验的乐趣。童年的回忆,变成了可以自己构建、修改并分享的东西。

Snake ↗ · Galaga ↗

滑动或使用箭头键·Esc 关闭